硬件:EC600M-CNLE(EC600X-EVB 底板),ST7789 240×240 屏,板载麦克风、NS4160 功放 + 小喇叭、AHT20 温湿度 运行环境:QuecPython,QPYcom V4.1.0 下载到 /usr 目录运行 功能效果:KEY1 按键唤醒后录音上传云端,经 ASR → LLM → TTS 处理,设备端接收云端下发的语音音频流播放;待机屏幕轮显主页面(时间/温湿度)、运行统计页(延迟/内存/Flash/信号)和像素表情页;15 秒无操作自动回到待机。 本帖为本周 QuecPython 实训系列记录的第一篇:知识总结 + 踩坑解决过程。
一、项目核心能力
综合练习 4G 蜂窝联网、音频录放、三态状态机、裸 LCD 界面绘制、板载传感器读取。端云分工:设备端只负责采集、播放、显示和状态管理;语音识别、对话理解、语音合成全部放在云端完成,设备端不做本地 TTS。
二、工程结构
代码按模块拆分,方便后续接传感器和调整界面:
| 文件 | 职责 |
|---|---|
main.py / voice_main.py |
主程序入口,启动状态机和主循环 |
config.py |
引脚、网络接口、TTS/ASR 参数、界面配色与轮显时长等常量 |
driver.py |
屏幕绘制、卡片、文字、精灵位图加载等显示驱动 |
voice_driver.py |
三态状态机、录音/播放调度、云端任务线程、统计数据 |
asr.py |
百度语音识别(ASR)取 token 与上传录音 |
tts.py |
百度 TTS 文本分段、请求合成、音频格式探测与落盘 |
aht20.py |
AHT20 温湿度 I2C 读取 |
mic_driver.py |
麦克风录音控制与录音回放测试 |
runtime_stats.py |
各环节耗时、内存/Flash、失败/恢复/异常次数统计 |
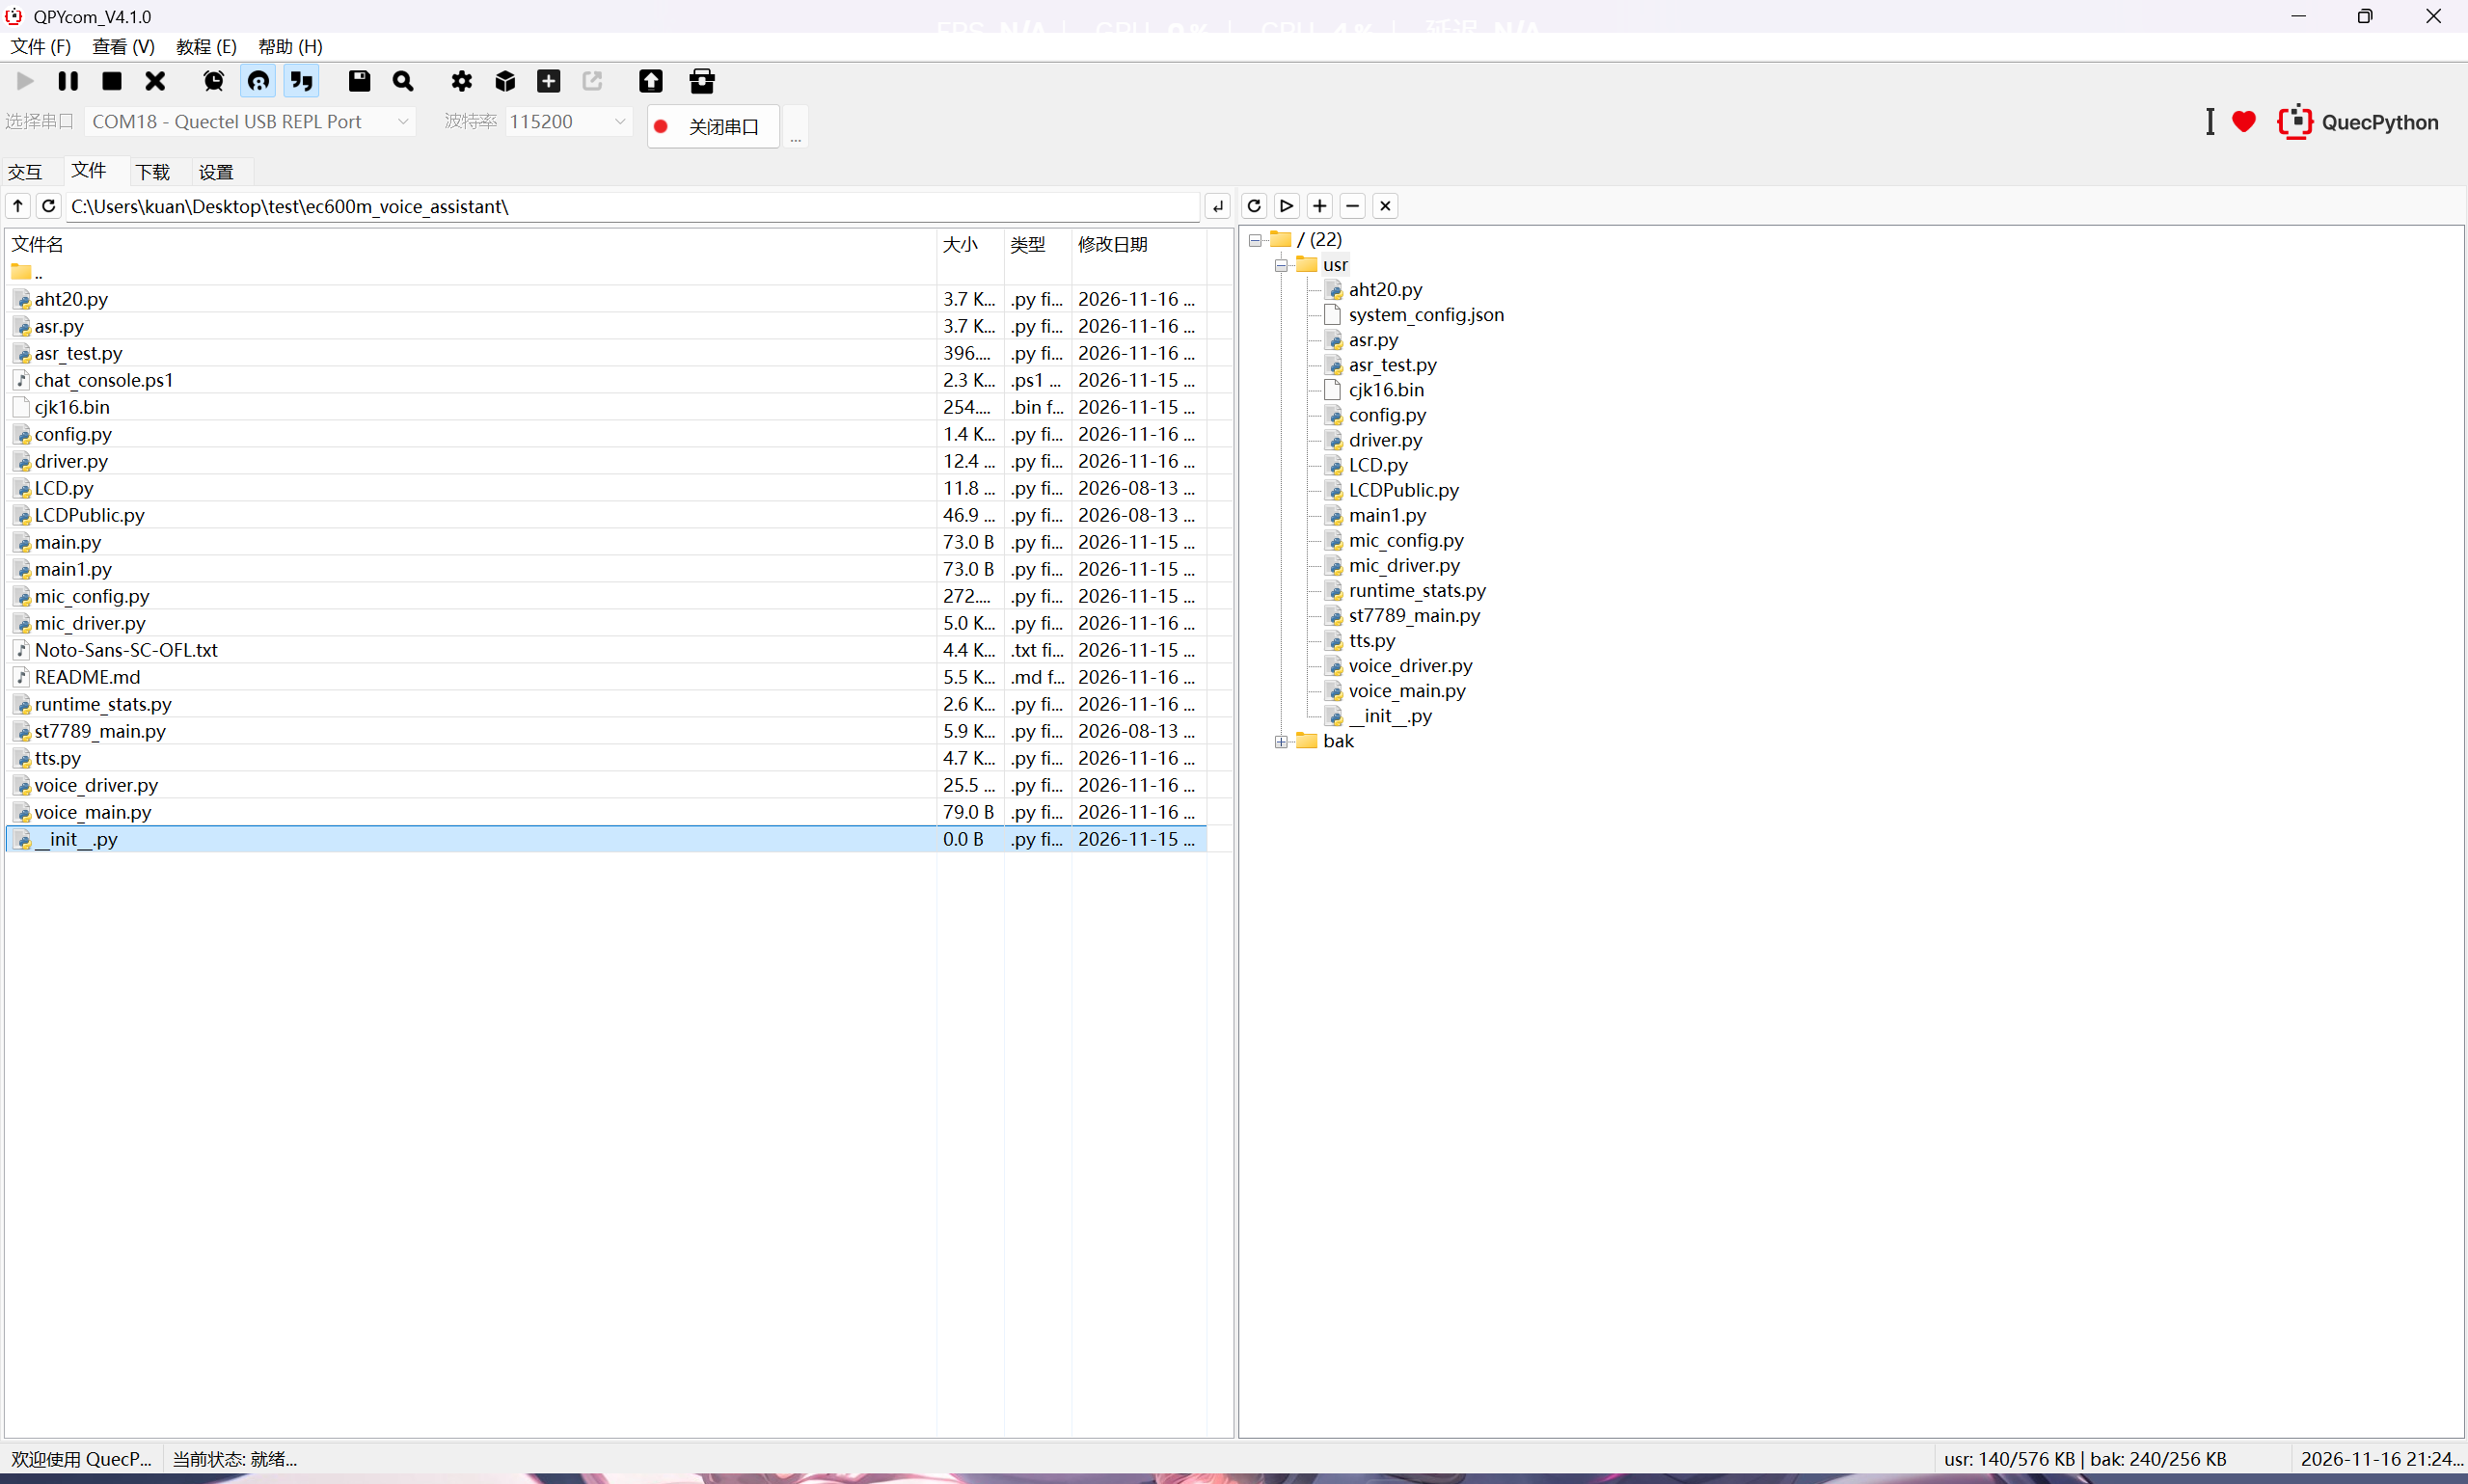
QPYcom V4.1.0 通过 Quectel USB REPL Port(波特率 115200)连接,工程文件下载到板子 /usr/ 目录后运行:
三、硬件与引脚
| 模块 | 接口 | 引脚 / 说明 |
|---|---|---|
| 温湿度 AHT20 | I2C | SCL=56,SDA=57 |
| 光敏 GT36528 | ADC | 引脚 19(预留,暂不接入对话) |
| 麦克风 | — | 引脚 23、24 |
| 功放 NS4160 | — | 引脚 21、22,喇叭接 SPK+ / SPK- |
| 显示屏 ST7789 | SPI | 引脚 63~67,240×240 |
| 按键 | GPIO | KEY1=唤醒/录音,KEY2=翻页 |
四、关键实现
整个交互由三个状态驱动,业务逻辑不散落在主循环里:
-
STANDBY:待机,屏幕轮显,等待唤醒;
-
LISTENING:聆听中,录音上传;
-
REPLYING:播报中,播放云端返回的语音音频流。
每次交互结束后重置 15 秒无操作计时器;超时自动回到 STANDBY,回到待机时默认落在主页面。
-
语音处理全部在云端:ASR 语音识别 → LLM 对话理解(DeepSeek)→ TTS 语音合成(百度);
-
设备端不做本地 TTS 合成,只接收云端下发的音频流,用
playStream流式播放; -
本地语音唤醒词检测在模组上不可靠,本项目改用 KEY1 按键唤醒,不做唤醒词识别。
串口上能看到完整链路日志:
Recognized: 介绍一下你。
DeepSeek: 我是……(大模型回复文本)
Reply audio ready.
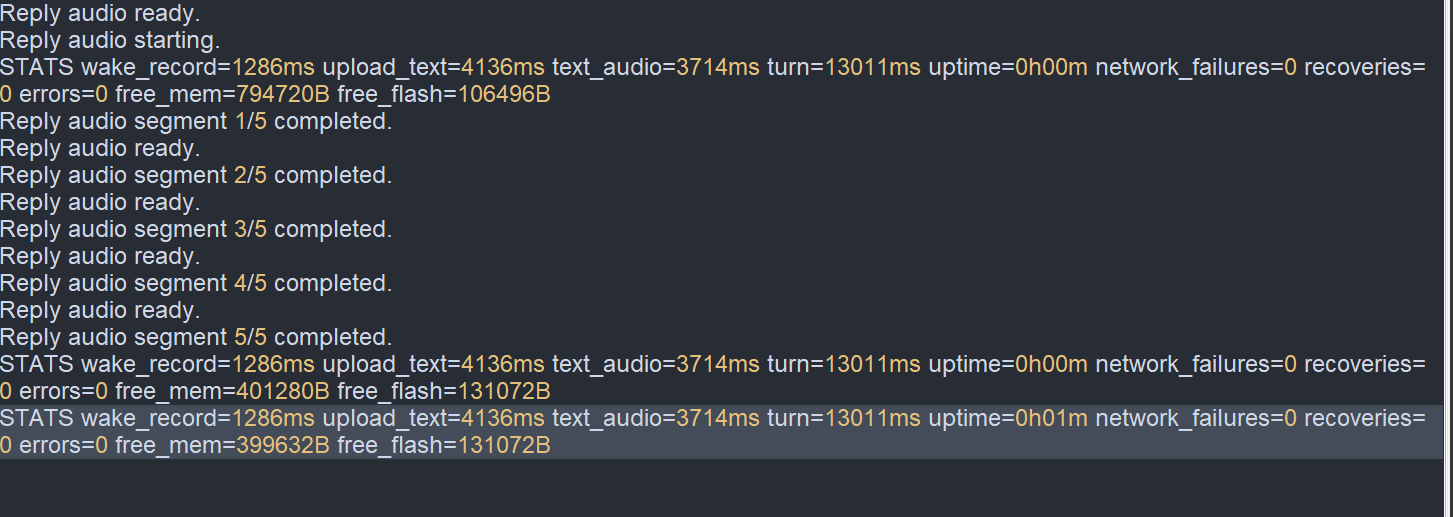
Reply audio segment 1/6 completed.
Reply audio segment 2/6 completed.
...
STATS wake_record=1286ms upload_text=4136ms text_audio=3714ms turn=13011ms free_mem=794720B free_flash=106496B
串口实测分段播报与统计日志:
-
240×240 裸屏直接用 LCD 原生接口画点、画字、画矩形,不引入 LVGL;
-
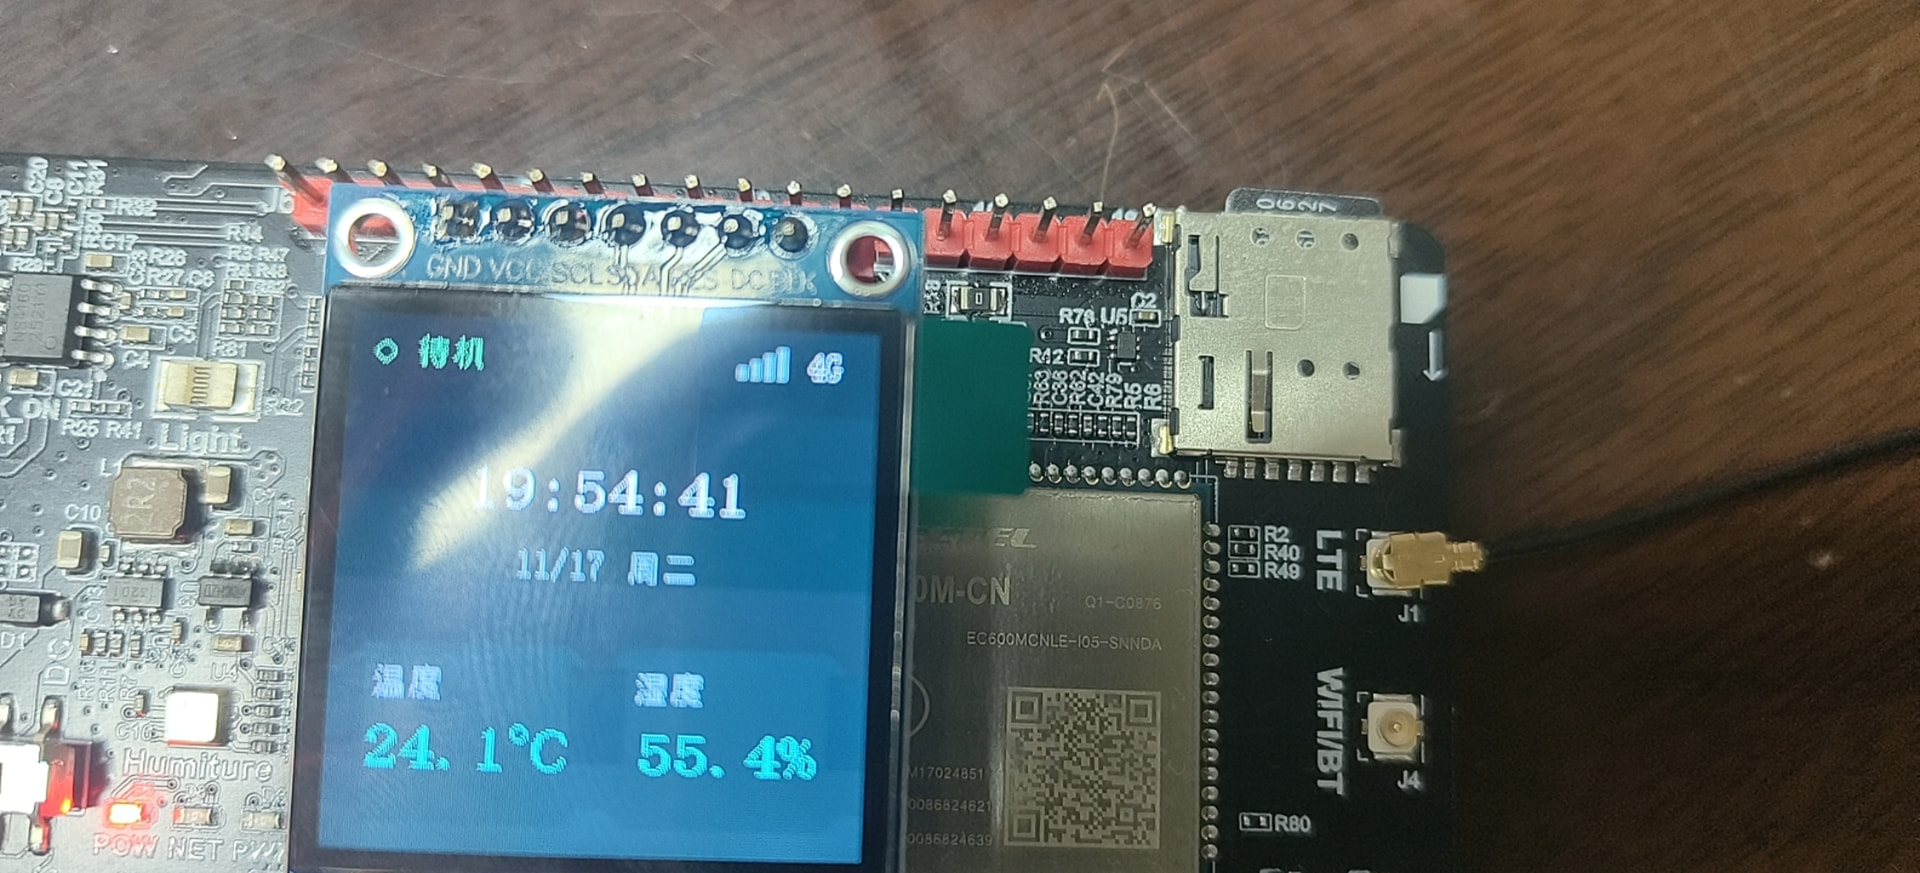
待机轮显三个页面:
-
- 主页面:时间、日期、温度、湿度;
-
- 统计页:录音/上传/播报/整轮耗时、运行时长、重连/恢复/异常次数,以及内存、Flash 进度条和信号格;
-
- 表情页:三张像素精灵(绿心团子、方块小猫、黄瞳白猫)按顺序轮换,每轮只显示一个,索引跨轮保留;
-
整页批量渲染:先取完本页全部数据,再一次性绘制,避免逐行出现;数据周期整页刷新。
-
通过
net.csqQueryPoll()获取 CSQ 值(0~31,-1失败、99异常); -
映射成 1~4 格信号条:无信号/异常 1 格灰色,0~9 一格,10~15 两格,16~21 三格,22~31 满格;
-
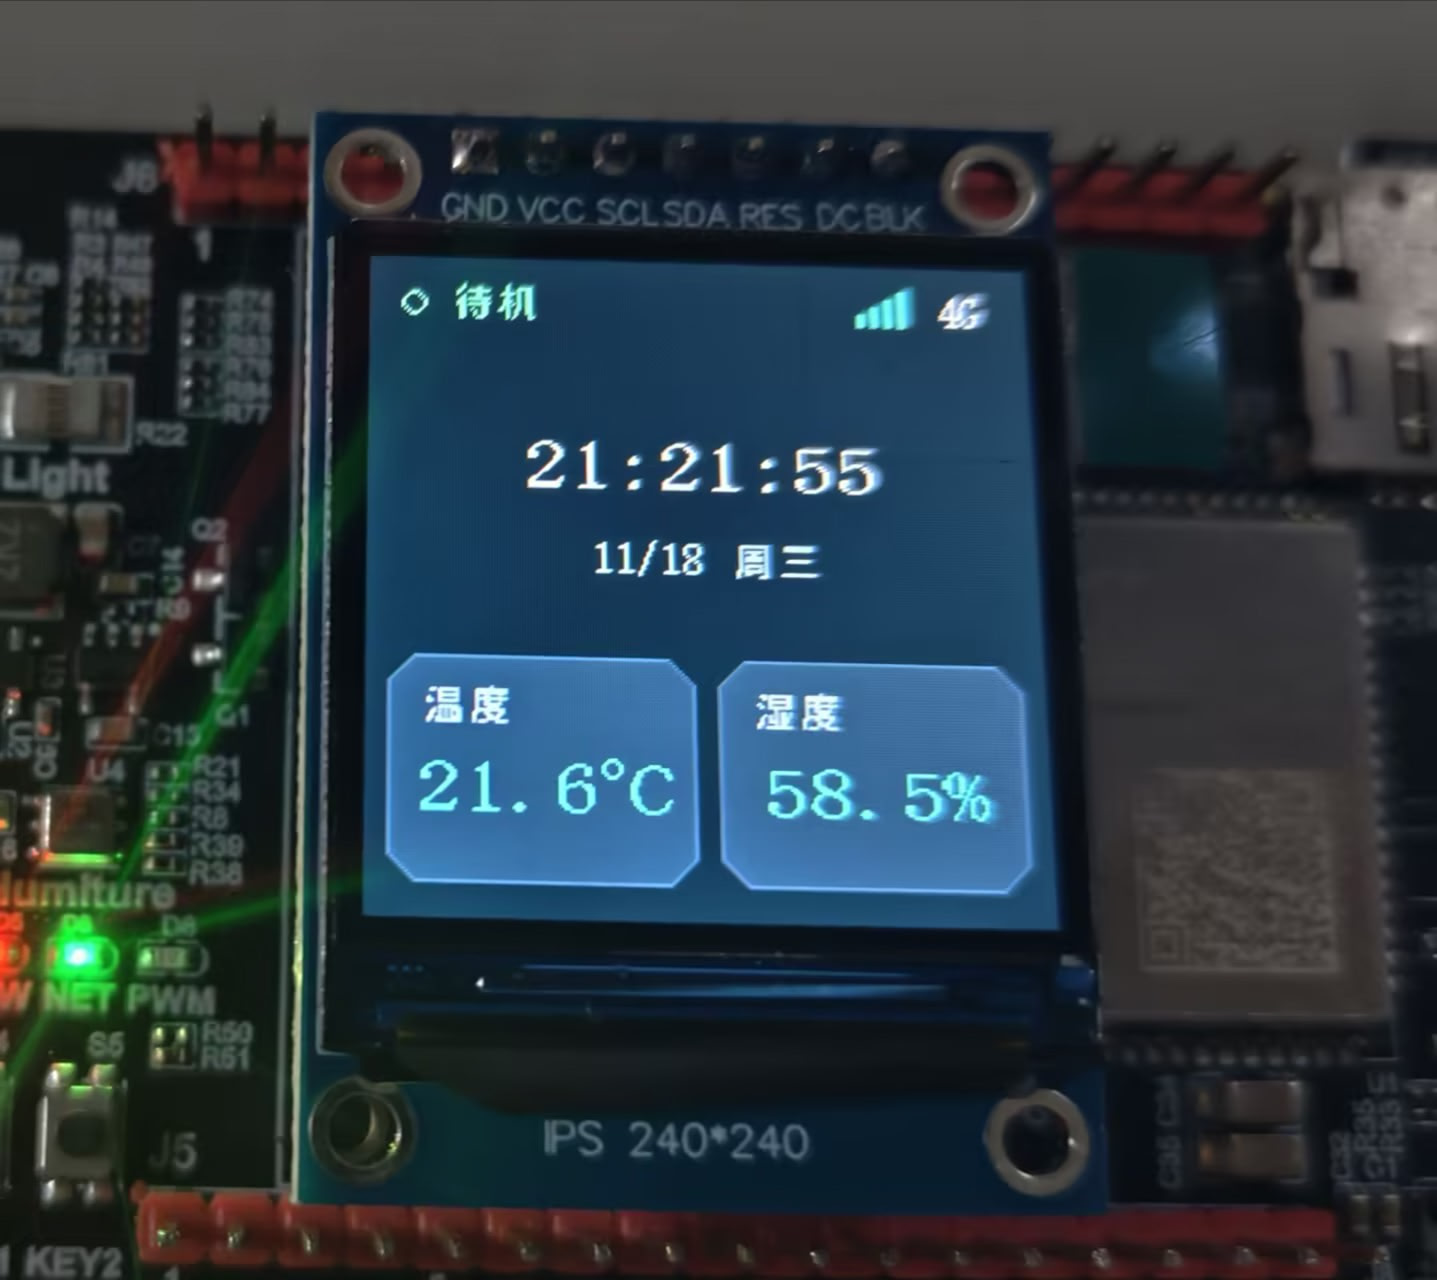
实拍待机页可见 ONLINE、CSQ 27、IDLE、温湿度 34.0℃ / 47%。
| 项目 | 数据来源 | 总量计算 |
|---|---|---|
| 内存 | gc.mem_alloc() / gc.mem_free() |
堆总量 = 已用 + 余量 |
| Flash(usr/bak) | uos.statvfs(path) |
总量 = f_bsize × f_blocks;余量 = f_bsize × f_bavail;占用 =(总量 − 余量)/ 总量 |
状态栏显示口径为「余量 / 总量」,例如 usr: 96/576 KB 表示余量 96KB、总量 576KB。比例限制在 0~100%,占用超过 85% 进度条变红提醒;总量读取失败时只画空轨道,不估算比例。
五、完整运行流程
-
待机:屏幕在主页面、统计页、表情页之间轮显,监听 KEY1 唤醒和 KEY2 翻页;
-
唤醒:按下 KEY1 进入 LISTENING,屏幕显示“聆听中…”,开始录音;
-
上传与云端处理:音频上传云端,依次完成 ASR、LLM、TTS;
-
播报:进入 REPLYING,接收云端语音音频流并通过功放喇叭播放,屏幕显示“播报中…”;
-
回到待机:播报结束或 15 秒无操作,释放音频通道,复位状态与计时器,回到主页面待机。
六、调试过程与踩坑记录
-
现象:写完代码在编辑器里直接运行,报找不到模块。
-
原因:这是给 EC600M 开发板写的 QuecPython 程序,不能在电脑上直接跑。
-
解决:用 QPYcom 连接模组串口(Quectel USB REPL Port,波特率 115200),把文件下载到板子
/usr/目录后再example.exec('/usr/voice_main.py')运行。
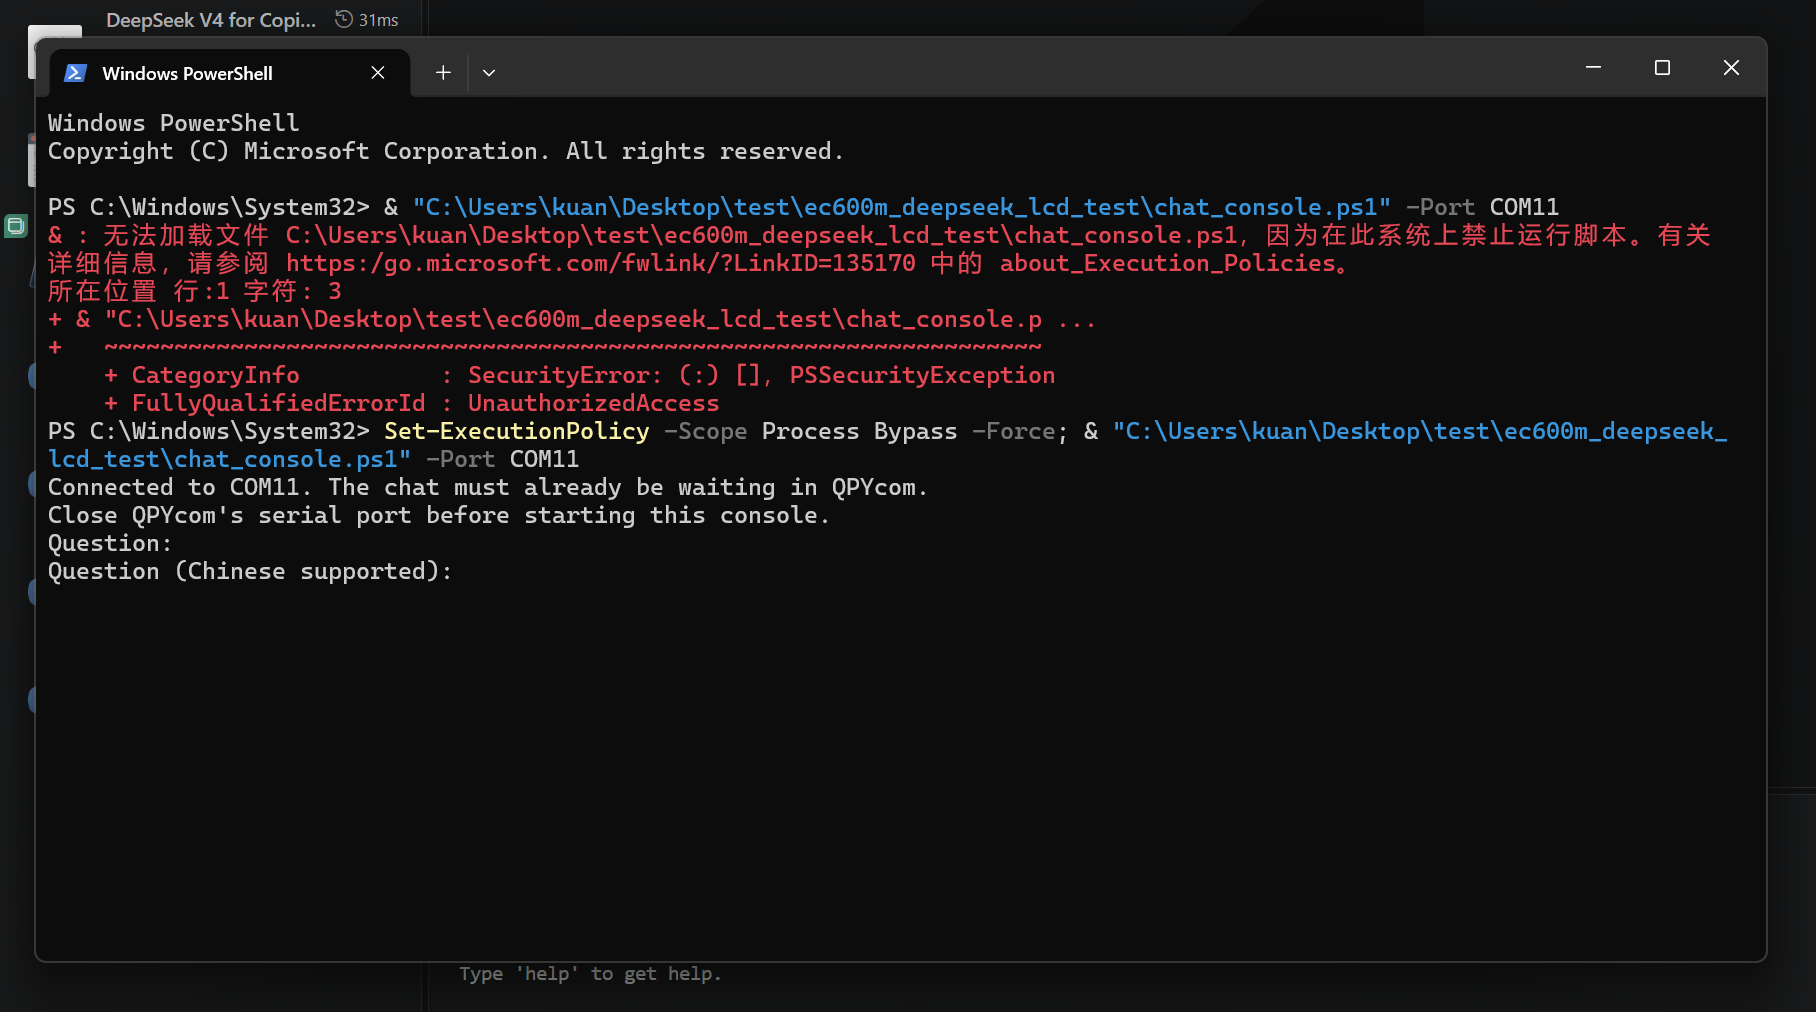
- PowerShell 禁止运行 .ps1 调试脚本
-
现象:PC 端先用
chat_console.ps1 -Port COM11联调云端对话,报错PSSecurityException / UnauthorizedAccess,提示系统禁止运行脚本。 -
解决:仅对当前进程放开执行策略:
Set-ExecutionPolicy -Scope Process Bypass -Force
再运行脚本连接 QPYcom 已打开的串口,先在 PC 端把 DeepSeek 对话链路调通,再移植到模组:
两类 401 都遇到过。
DeepSeek LLM 鉴权:请求对话时报 authentication_error,提示 api key 无效:
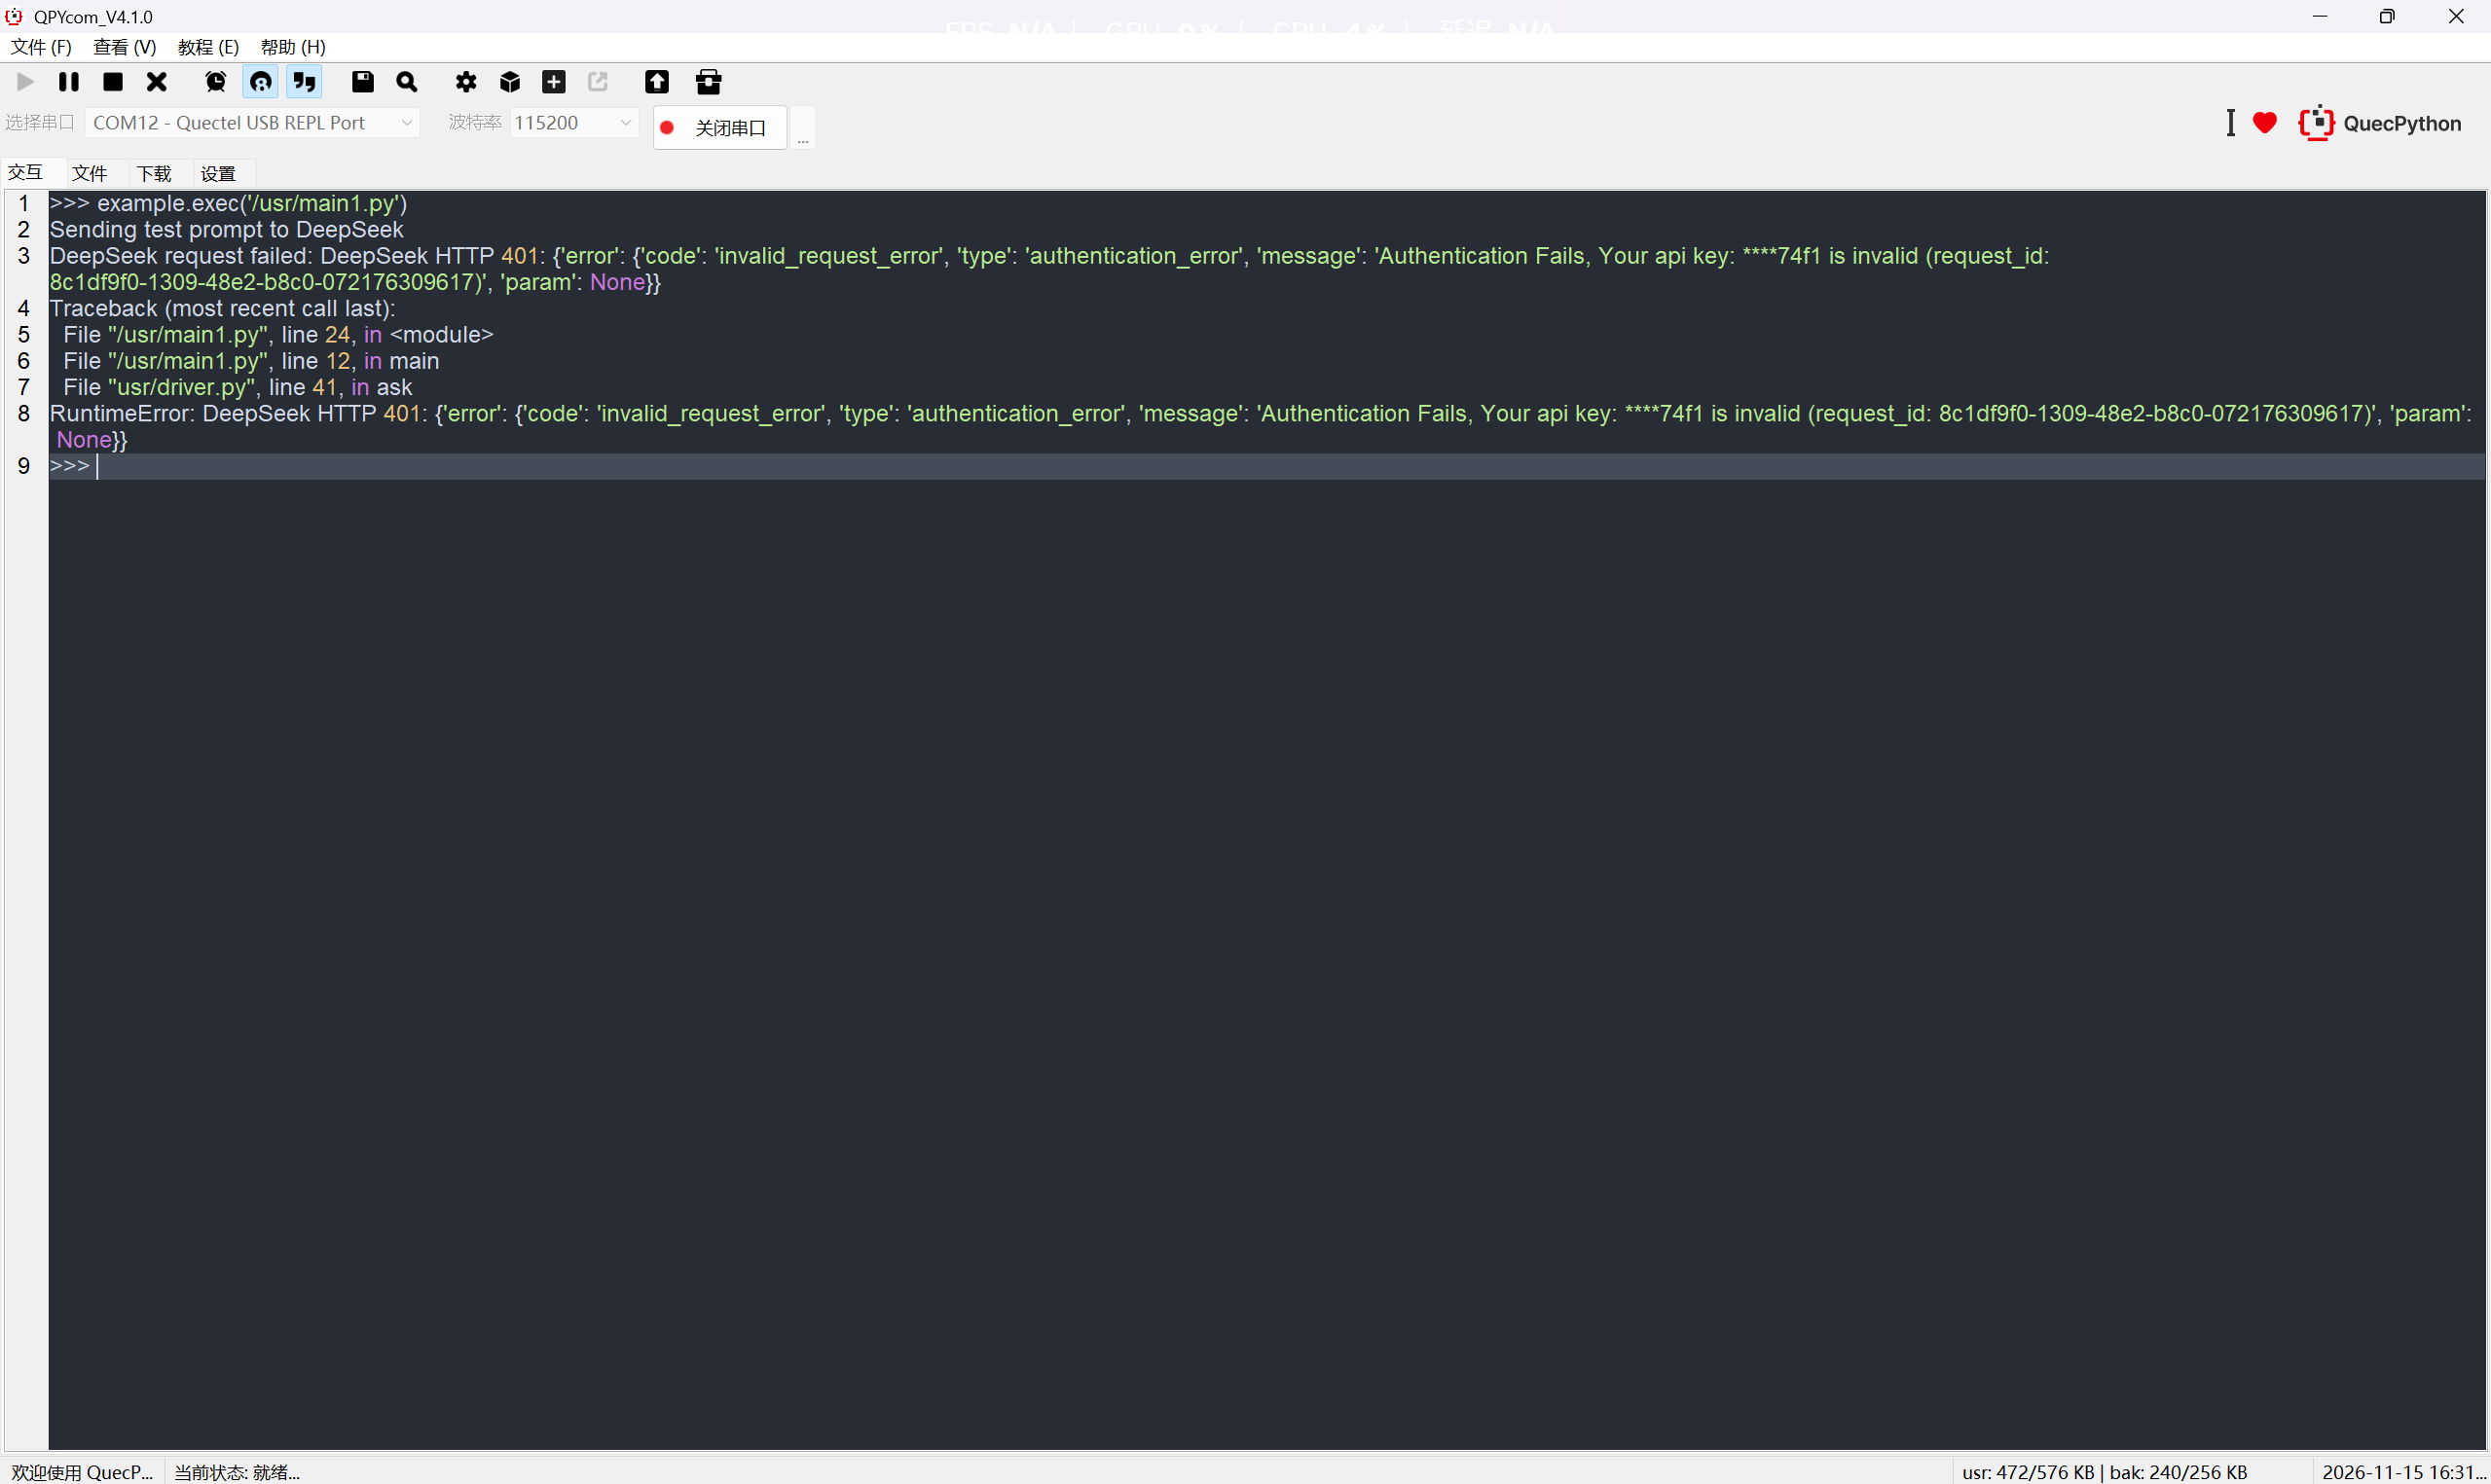
DeepSeek request failed: DeepSeek HTTP 401: {'error': {'code': 'invalid_request_error',
'type': 'authentication_error', 'message': 'Authentication Fails, Your api key: ****74f1 is invalid'}}
百度 ASR token:录音上传前获取 token 失败:
Baidu ASR token HTTP 401: {'error_description': 'Client authentication failed', 'error': 'invalid_client'}
-
原因:API Key / Secret Key 填写错误,或 access_token 申请字段、鉴权方式不对。
-
解决:分别核对 LLM 与 ASR 控制台的 Key、Secret Key,检查请求地址、鉴权头和返回字段,确认鉴权通过后再上传录音。
-
现象:回复较长时报错
TTS text exceeds the configured 100-character limit。 -
解决:在
tts.py里按标点把回复切成分段文本(句号、问号、感叹号、逗号等边界优先),逐段送 TTS;单段文本不超过服务端字数上限。
-
现象一:
Content-Type: audio/mp3未被识别,日志提示 unknown,最后靠文件头探测到格式 3(MP3)。 -
现象二:
Reply audio failed: 'bytearray' object has no attribute 'startswith'。 -
原因:
response.content是 bytearray,不能直接调字符串的startswith;Content-Type 也可能和实际编码不一致。 -
解决:判断类型前先转成
bytes;除了看 Content-Type,再用文件头(ID3 / 0xFFE0 等)探测音频格式,映射到playStream的 format 参数(2=WAVPCM,3=MP3,4=AMRNB)。
-
现象:
Reply audio failed: Baidu TTS audio exceeds size limit。 -
原因:单段音频字节数超过本地 Flash 可写上限。
-
解决:控制单段文本长度和音频字节上限;分段合成、分段播放;段音频优先走内存缓冲,不往 Flash 临时目录写大文件。
-
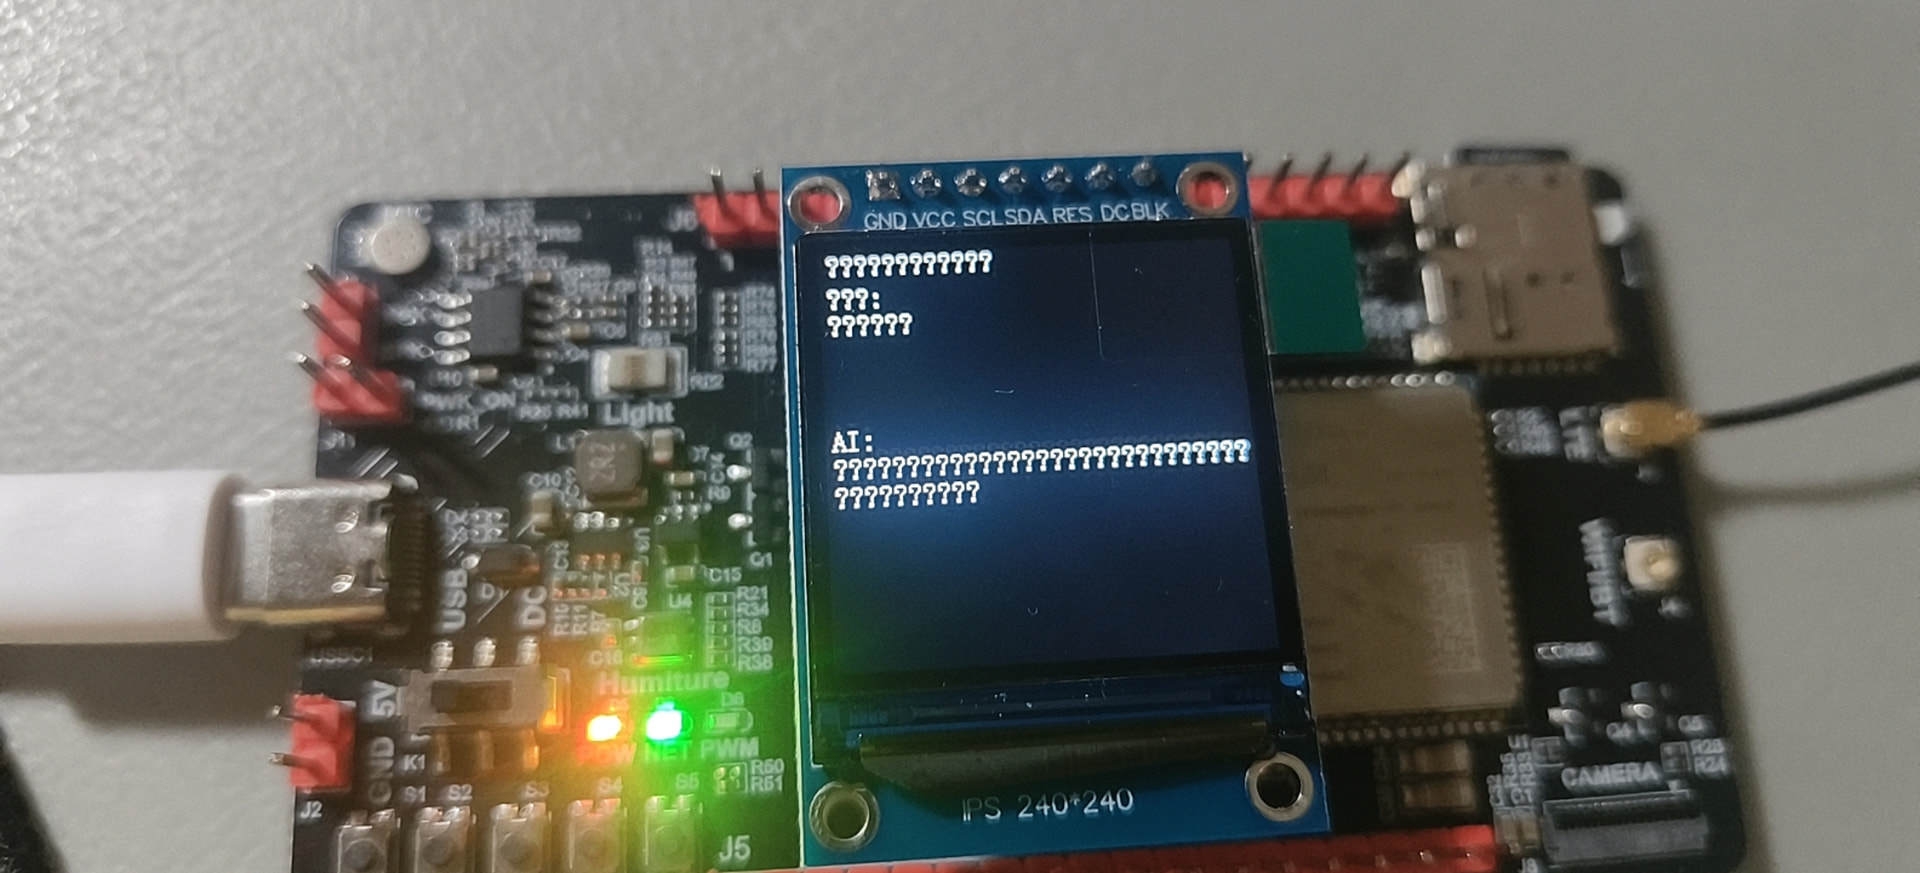
现象:读取
cjk16.bin字库时出现NameError: name 'n' is not defined、ValueError: arg out of range(256)一类错误。 -
原因:字库魔数、尺寸偏移和点阵数据读取位置算错,字节取值超出 0~256 范围。
-
解决:按字库格式重新核对文件头魔数、宽高偏移和点阵索引公式,逐段
seek/read校验字节范围后再上屏取模。
- 现象:启动画主页面时报错,定位到
driver.py的_draw_gradient_background:
TypeError: 'bytearray' object doesn't support item assignment
**原因**:裸 LCD 帧缓冲是 bytearray,渐变逐像素改写方式不被支持;且 RGB565 颜色分层有限,渐变本身也容易出色带、色块。
- 解决:放弃渐变,背景统一用纯色;温度/湿度卡片底色与背景太淡看不清时,提亮卡片底色并加 1px 描边拉开层次。
-
现象:
uos.listdir("/usr/")报OSError: [Errno 19] ENODEV,而空路径uos.listdir("")能看到usr、bak目录。 -
解决:核对 QuecPython 文件系统路径写法,目录枚举和文件读写按模组支持的路径格式调整,避免硬编码带尾斜杠的绝对路径。
-
现象:VSCode 提示
Could not keep the changes to config.py: another chat in this session also changed it。 -
解决:AI 辅助生成时避免多个对话同时改
config.py;改动前先合并现有配置,再统一落盘,防止引脚、参数被覆盖。
EC600M 只有一路音频通道,录音和播放不能同时占用;切换录音/播放前必须先释放上一路通道,否则会出现无声或通道占用异常。
按键、音频等回调只做事件标记和通道切换;耗时的网络请求、音频合成、界面刷新放到主流程或后台线程/定时器回调里处理,避免阻塞中断和播放线程。
七、本周学习感悟
-
事件驱动的分工:课堂 GPIO 实验里中断只负责捕获按键边沿,消抖和业务交给软件/硬件定时器;语音项目里回调也只做事件标记和通道切换,耗时的网络请求、音频合成、界面刷新放到主流程或后台线程。这是嵌入式开发最基本的思路。
-
模块化拆分的好处:把引脚配置、云端参数、显示驱动、录音播放调度、传感器读取分开成
config、driver、voice_driver、asr、tts、aht20等模块后,改界面或调参数不容易把业务代码搅在一起,也方便定位问题。 -
串口日志是调试主线:这次每个环节都在串口打日志——识别文本、大模型回复、音频分段完成、各环节耗时、剩余内存/Flash、失败次数。出问题先看日志停在哪一步,比反复猜硬件或网络更有效。
-
AI 辅助要对照真机核对:VSCode AI 插件能快速生成代码框架,但引脚号、文件路径、QuecPython 接口、
bytearray/bytes类型这些细节必须对照官方文档和实机日志核对,不能直接照搬。 -
端云分工的体会:EC600M 模组资源有限,本地只做录音、播放、显示和状态管理,ASR、对话理解、语音合成放云端;本地唤醒词检测和本地 TTS 受模组能力限制,本项目改用按键唤醒,也是结合硬件能力做的取舍。
-
不足与后续:分段播报段间停顿、模型人设、传感器语音联动还没做完,计划在后续系列帖里继续记录优化过程。
八、待优化与拓展
-
传感器语音联动(预留):后续可让对话中读取本地温湿度、光敏数据回答,本次实训暂未接入;光敏引脚仅预留。
-
摄像头识图:扩展外接摄像头拍照,走云端识图/大模型理解。
-
音色与唤醒优化:TTS 音色由云端侧切换;本地唤醒词受模组能力限制,如需远场唤醒需评估外接语音芯片方案。