在 Quectel Pi M2 Debian 系统上,基于 OCR 文字识别算法 SDK(DeepOCR),从零搭建一个带桌面图形界面的文字识别项目。
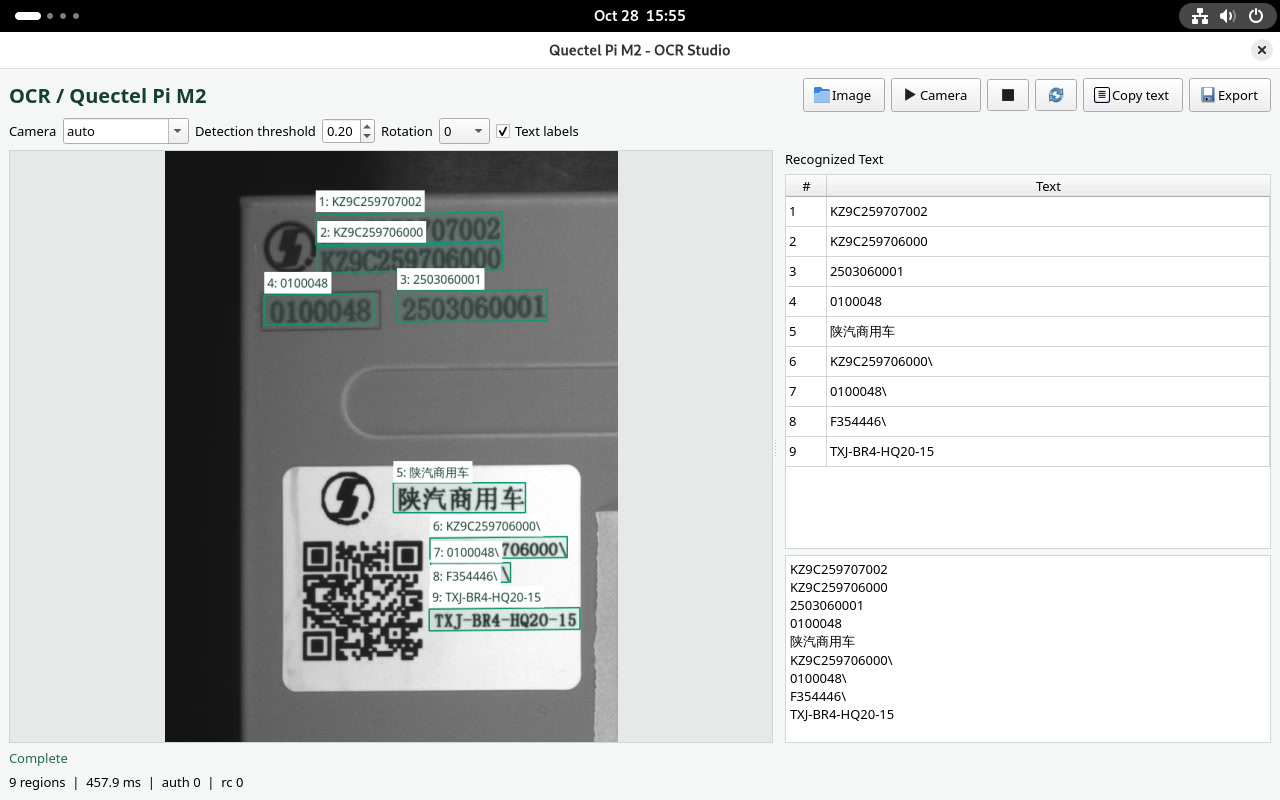
界面采用「工具栏 + 左图右文」双区布局:
- 顶部工具栏 —— 图片 / 摄像头 / 停止 / 重新识别 / 复制文本 / 导出,以及摄像头、检测阈值、旋转、文字标签等参数;
- 左侧显示区 —— 原图或摄像头实时画面,叠加文字检测多边形与文本标签;
- 右侧结果区 —— 识别结果表格(序号 + 文本)与完整文本视图。
提供两种体验方式:
- USB 摄像头 —— 打开 USB 摄像头,实时识别画面中的文字;
- 本地图片 —— 选择一张本地图片,离线识别其中的文字。
算法能力
| 项目 | 说明 |
|---|---|
| 算法类型 | 文字检测 + 文字识别(检测定位文本行,识别输出文字内容) |
| 模型 | sim.engine(检测 + 识别一体化 RKNN 模型) |
| 输入 | BGR 连续内存(cv::Mat.data,rows×cols×3) |
| 输出 | 每个文本区域一个 Ocr_Rec_Result(多边形框 + UTF-8 文本) |
| 语言 | 中英文、数字、常见符号(以模型实际能力为准) |
算法输出文本与区域坐标,不含逐条置信度;文本按模型返回顺序给出,不额外保证自然阅读顺序。不提供翻译、表格结构还原、手写识别保证或二维码解码。
部署前准备
资源获取
| 名称 | 说明 |
|---|---|
RK_OCR_NPU_1.2(算法 SDK 包) |
OCR 文字识别完整包;本工程使用包内 RK3576 Linux 的 deep_ocr(含公开头、动态库、第三方运行时、模型与样例图) |
| ocr_project(Demo 工程) | 本教程提供的示例工程,含源码、Makefile 与三个脚本(复制依赖 / 编译 / 运行) |
算法 SDK 包 deep_ocr(RK3576 Linux)的关键目录:
RK_OCR_NPU_1.2/
└── RK_OCR_NPU/RKNN-2.3.2-linux/rk3576/deep_ocr/   # 本工程使用的 RK3576 Linux 包
    ├── include/deep_ocr.h              # 算法公开头(集成时唯一需要包含的头)
    ├── lib/aarch64_Linux/
    │   ├── libdeep_ocr.so              # 算法封装库(对外 DeepOcr 类)
    │   └── libdeepocr.so               # OCR 核心实现(检测 + 识别)
    ├── 3rd_party/
    │   ├── opencv_4.2.0/               # 随包 OpenCV world(头 + libopencv_world.so)
    │   ├── jsoncpp_1.9.5/              # JSON 运行时
    │   ├── license/                    # 授权运行时 libauthorization.so
    │   └── rknn_2.3.2/librknnrt.so     # RKNN 硬件运行时
    ├── models/
    │   ├── sim.engine                  # OCR 检测 + 识别模型
    │   └── model_ocr.json              # 模型预处理配置(参考)
    ├── images/111.png                  # 示例图片
    └── src/main.cpp                    # 官方最小调用示例
硬件/系统要求
| 项目 | 要求 |
|---|---|
| 主控 | Quectel Pi M2(RK3576) |
| 系统 | Debian / Ubuntu aarch64(带桌面环境,Wayland 或 X11) |
| 外设 | USB 摄像头(体验实时识别时需要) |
| 连接 | PC 可通过 adb shell 进入设备 |
软件要求
Demo 在 Quectel Pi M2 上本地编译,需确认以下软件已安装:
g++ --version          # C++17 编译器
make --version
pkg-config --exists Qt5Widgets Qt5Gui Qt5Core && echo "Qt5 OK"   # 显示用 Qt5(LGPL)
v4l2-ctl --version     # 用于枚举和排查 USB 摄像头节点
界面方案说明:显示层采用系统自带的 Qt5,直接在桌面显示;采集/推理/绘制使用工程内随包的 OpenCV world 单库,与系统 OpenCV 隔离。务必只链接 SDK 随包的
libopencv_world.so,不要混入系统 OpenCV——两者 ABI 不同,混用会导致初始化、授权均成功但inference返回-3。
工程结构
ocr_project/
├── src/
│   └── ocr_cam_demo.cpp         # Demo 主程序(Qt 界面 + 采集/推理双线程 + 导出)
├── include/                     # setup 后:SDK 公开头 deep_ocr.h
├── lib/                         # setup 后:libdeep_ocr.so / libdeepocr.so 与随包 OpenCV world
├── models/                      # setup 后:sim.engine / model_ocr.json
├── images/                      # setup 后:样例图
├── Makefile                     # 编译规则
├── build.sh                     # 一键编译
├── setup_from_sdk.sh            # 从 SDK 包复制依赖到本工程
├── run.sh                       # 一键运行(配置环境变量 + 启动)
└── README.md / README.zh.md     # 中英文说明文档
include/ lib/ models/ images/ 由 setup_from_sdk.sh 从原始 SDK 包复制生成。
核心代码讲解
Demo 基于 SDK 公开头 deep_ocr.h 的单类 DeepOcr,调用生命周期为:构造 → set_param(设阈值)→ init(加载模型+授权)→ inference(逐帧推理)→ uinit(释放)。
源码位于 src/ocr_cam_demo.cpp,下面按调用顺序讲解关键片段。
初始化
DeepOcr sdk;
float conf = 0.2f;                 // OCR 检测置信度阈值
sdk.set_param(conf);               // 必须在 init 之前设置

char model[]   = "models/sim.engine";
char license[] = "license/ocr.lic";           // 可写的授权文件路径(首次运行由 SDK 生成)
// p_auth 为算法授权码,经环境变量 OCR_AUTH_CODE 下发(SDK 不内置)
std::string auth = std::getenv("OCR_AUTH_CODE") ? std::getenv("OCR_AUTH_CODE") : "";

OCR_RES_CODE rc = sdk.init(model, license, 3, auth.data());   // RK3576 固定 module=3
int model_status = sdk.get_status(0);   // 0 成功,-1 模型初始化失败,-4 JSON 解析错误
int auth_status  = sdk.get_status(1);   // 0 正式授权,其他值为授权错误码
if (rc != OCR_PROCESS_OK || model_status != 0 || auth_status != 0) {
    // 初始化失败:检查授权码 / 模型路径 / 许可证可写
}
参数说明:
set_param(conf_thread):OCR 检测置信度阈值,默认0.2。调高减少误检,调低召回更多文本区域。该阈值在init阶段写入配置生效,必须在init之前调用;运行中若要更换阈值,需销毁实例并重新init。init(p_ocr_model, p_license_file, module, p_auth_code)加载模型并完成授权,四个参数依次为:p_ocr_model:OCR 模型路径(sim.engine)。p_license_file:算法授权文件的可写路径。项目中的run.sh通过OCR_LICENSE_FILE传入工程内绝对路径(默认license/ocr.lic),首次联网授权成功后生成,后续复用。module:平台标识,RK3576 固定传3。p_auth_code:算法授权码(SDK 不内置,经OCR_AUTH_CODE环境变量下发)。
- 返回码
OCR_RES_CODE:0=OCR_PROCESS_OK成功,其余为错误(见下表)。rc必须判等OCR_PROCESS_OK、且get_status(0)、get_status(1)均为0,才算真正可用——不能仅凭日志里的init success判断。 get_status(opt)查询状态:get_status(0)返回初始化状态(0成功);get_status(1)返回授权状态(0正式授权)。
推理
每一帧(摄像头帧或本地图片)都调用一次 inference,SDK 内部完成「文本检测 → 文本识别」的完整流程,返回每个文本区域的坐标与文字。
std::vector<OCR_Rec_Result> results;
// 入参:BGR 数据指针、行(高)、列(宽)、通道数(必须 3)、输出结果向量
OCR_RES_CODE rc = sdk.inference(bgr.data, bgr.rows, bgr.cols, bgr.channels(), results);
if (rc != OCR_PROCESS_OK) { /* 推理失败 */ }

for (const auto& r : results) {
    // r.box  : 文本区域多边形点集(原图像素坐标,通常 4 个点 [x, y])
    // r.text : 识别出的 UTF-8 文本
    std::vector<cv::Point> pts;
    for (const auto& p : r.box) if (p.size() >= 2) pts.emplace_back(p[0], p[1]);
    cv::polylines(bgr, pts, true, cv::Scalar(0, 255, 0), 2);
}
输入约定:
- 必须是 BGR 连续内存(
cv::Mat默认即连续;若isContinuous()为假需先clone()再传.data)。 channels必须为3;灰度图需先cv::cvtColor转 BGR。- SDK 内部自动完成缩放、归一化与量化等预处理,调用方无需做任何预处理;若需要旋转纠正,应在送入前自行
cv::rotate,坐标将对应旋转后的图像。
输出结构 Ocr_Rec_Result(每个文本区域一个):
| 字段 | 含义 |
|---|---|
| box | 文本区域多边形点集,std::vector<std::vector>,每个点为 [x, y](原图像素坐标) |
| text | 识别出的文字内容(UTF-8 编码) |
结果坐标已换算回原图,可直接用于
cv::polylines/cv::putText叠加绘制;results为空且rc=0表示当前帧未检测到文字(属正常结果,非错误)。
释放
sdk.uinit(); // 释放内部引擎资源
返回码表
| 返回码 | 枚举 | 说明 |
|---|---|---|
| 0 | OCR_PROCESS_OK | 处理成功 |
| -1 | OCR_INIT_ERROR | 初始化失败(授权 / 模型路径) |
| -2 | OCR_UNINIT_ERROR | 反初始化失败 |
| -3 | OCR_ERR_INFERENCE_ERROR | 推理失败(空结果 / 执行错误,常见于 OpenCV 版本混用) |
| -4 | OCR_ERR_IMAGE_EMPTY | 输入图像为空 |
| -5 | OCR_ERR_JSON_NULL | 内部 JSON 为空 |
| -6 | OCR_ERR_JSON_PARSE | 内部 JSON 解析失败 |
最小接入示例
集成到自有工程时,只需包含 deep_ocr.h,链接 libdeep_ocr.so 与随包 OpenCV world,即可用下面的骨架接入:
#include "deep_ocr.h"

int main() {
    DeepOcr sdk;
    sdk.set_param(0.2f);

    char model[]   = "models/sim.engine";
    char license[] = "license/ocr.lic";
    char* auth     = std::getenv("OCR_AUTH_CODE");          // 由环境变量下发
    if (sdk.init(model, license, 3, auth) != OCR_PROCESS_OK
        || sdk.get_status(0) != 0 || sdk.get_status(1) != 0) {
        return 1;                                            // 初始化 / 授权失败
    }

    cv::Mat bgr = cv::imread("images/111.png", cv::IMREAD_COLOR);
    if (!bgr.isContinuous()) bgr = bgr.clone();
    std::vector<OCR_Rec_Result> results;
    if (sdk.inference(bgr.data, bgr.rows, bgr.cols, bgr.channels(), results) == OCR_PROCESS_OK) {
        for (const auto& r : results) printf("%s\n", r.text.c_str());
    }

    sdk.uinit();
    return 0;
}
Demo 的摄像头实时识别采用采集与推理双线程解耦:采集线程按摄像头帧率持续刷新预览,推理线程对最新帧异步做 OCR 并叠加结果框。因此预览流畅、不随单次推理耗时卡顿;文字框按 OCR 完成节奏更新。集成实时场景时建议沿用该模式,并保证单线程串行持有 SDK(界面/采集线程不并发调用
inference)。
部署与运行
传输文件
以下分为 PC 端和设备端命令。PC 示例使用 Windows PowerShell;adb push 先把目录传到设备 /tmp。
adb 传输示例:
# adb push 传输文件夹先放到 Quectel Pi M2 的 /tmp 下(RK_OCR_NPU_1.2 为整个 SDK 包)
adb push RK_OCR_NPU_1.2 /tmp/
adb push ocr_project /tmp/
推送完成后,在 Quectel Pi M2 桌面会话中打开终端,以普通用户执行下列命令。
# $HOME 和 $USER 由设备 shell 展开;不要在 root adb shell 中执行,否则它们会指向 root 用户
sudo mv /tmp/RK_OCR_NPU_1.2 /tmp/ocr_project "$HOME"/
sudo chown -R "$USER:$USER" "$HOME/RK_OCR_NPU_1.2" "$HOME/ocr_project"
cd "$HOME/ocr_project" && chmod +x *.sh
安装编译环境和开发工具
在 Quectel Pi M2 终端中输入以下命令:
# 安装 make,g++ 等开发工具
sudo apt update && sudo apt install -y build-essential pkg-config qtbase5-dev
复制依赖
setup_from_sdk.sh 从 SDK 包把头文件、动态库、第三方运行时、模型、样例图复制到工程对应目录:
cd $HOME/ocr_project
sh setup_from_sdk.sh $HOME/RK_OCR_NPU_1.2   # 自动定位 RK3576 Linux deep_ocr;不传参数默认 ~/RK_OCR_NPU_1.2
编译
sh build.sh
# 产物:$HOME/ocr_project/ocr_cam_demo
build.sh内部调用make:用系统 Qt5 做界面,链接工程内libdeep_ocr.so与随包 OpenCV world 生成可执行文件。
运行
在 Quectel Pi M2 桌面终端中运行:
# 先设置算法授权码
export OCR_AUTH_CODE="你的算法授权码"

sh run.sh                                     # 启动图形界面(默认)
sh run.sh --headless --image images/111.png   # 无界面识别单张图片(脚本/集成)
推荐从设备桌面会话的终端启动。若通过
adb shell启动,需切换到桌面登录用户,并确保XDG_RUNTIME_DIR、WAYLAND_DISPLAY或DISPLAY/XAUTHORITY与桌面会话一致。run.sh已自动探测 Wayland / xcb。
界面操作
| 操作 | 说明 |
|---|---|
| [Image] | 弹出文件选择框,选一张图片离线识别 |
| [Camera] | 打开 USB 摄像头,实时识别画面中的文字 |
| [■ 停止] | 停止采集并释放摄像头 |
| [⟳ 重新识别] | 对当前来源重试,并应用当前阈值 / 旋转设置 |
| Detection threshold | 检测置信度阈值(0.01–0.99),下次识别生效 |
| Rotation | 顺时针旋转 0 / 90 / 180 / 270 度 |
| Text labels | 开关图上的文字标签(区域框仍绘制) |
| [Copy text] | 复制当前成功帧的全部识别文本 |
| [Export] | 导出当前成功帧的结果文件 |
导出格式
一次成功导出生成同前缀的五个文件:
ocr_<时间戳>.png            # 多边形与文字标注图
ocr_<时间戳>_source.png     # 实际送入 SDK 的(旋转后)原图
ocr_<时间戳>.txt            # UTF-8 文本,按结果顺序换行
ocr_<时间戳>.json           # 结构化结果(文本 + 多边形 + 元信息)
ocr_<时间戳>.labelme.json   # LabelMe 多边形标注
授权说明
SDK 采用先引擎、后算法的两层授权,集成方只需提供算法授权码(p_auth_code),其余随包固定:
- 授权码通过环境变量
OCR_AUTH_CODE下发。run.sh已export一个占位符REPLACE_WITH_ALGORITHM_AUTH_CODE,集成方替换为自己的算法授权码,或运行前在环境中导出:
export OCR_AUTH_CODE="你的算法授权码"
sh run.sh
- 授权文件路径由
OCR_LICENSE_FILE指定,run.sh默认设为工程目录内的绝对路径license/ocr.lic;首次联网授权成功后生成,后续启动复用。 - 正确算法码 → 正式授权(
get_status(1)=0)。 - 空码或错误码会使授权校验失败,
get_status(1)返回非 0,算法不可用。 - 首次授权需要网络、正确的系统时间、匹配的设备指纹以及可写的许可证路径。
查询状态:get_status(0) 初始化状态(0 成功),get_status(1) 授权状态(0 正式授权)。
应用演示
常见问题排查
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
| 初始化失败 rc=-1 或 get_status(1)≠0 | 授权码为空/错误、许可证不可写、时间/网络异常 | 设置 OCR_AUTH_CODE;确认 license/ 可写;核对系统时间与网络 |
| init/auth 成功但 inference=-3 | 系统 OpenCV 与 SDK OpenCV 混用(ABI 冲突) | 用 ldd 确认只加载 SDK 的 libopencv_world.so,不要链接系统 libopencv_*.so |
| 窗口不显示 | 非桌面会话 / QT_QPA_PLATFORM 未匹配 | 在设备桌面会话运行;或由 run.sh 自动探测 Wayland/xcb |
| 无法打开摄像头 | USB 摄像头未插入 / 指定节点错误 | 默认 auto 自动探测 USB 采集节点;可用 v4l2-ctl --list-devices 确认后指定 /dev/videoN |
| 链接/运行报找不到 .so | LD_LIBRARY_PATH 未设置 | 用 run.sh 启动(已配置),或手动 export 工程内 lib 路径 |
| 识别结果为空 | 画面无文字 / 文字过小或模糊 / 阈值过高 | 让文字清晰入镜;适当调低 set_param 的检测阈值 |
技术支持与贡献
如在使用过程中遇到问题,欢迎在移远官方论坛提交技术咨询,移远技术支持团队将及时为您解答。
项目开源地址:https://github.com/Quectel-Pi/demo-edge-algorithms
欢迎提交Issue反馈问题或Pull Request贡献代码改进!