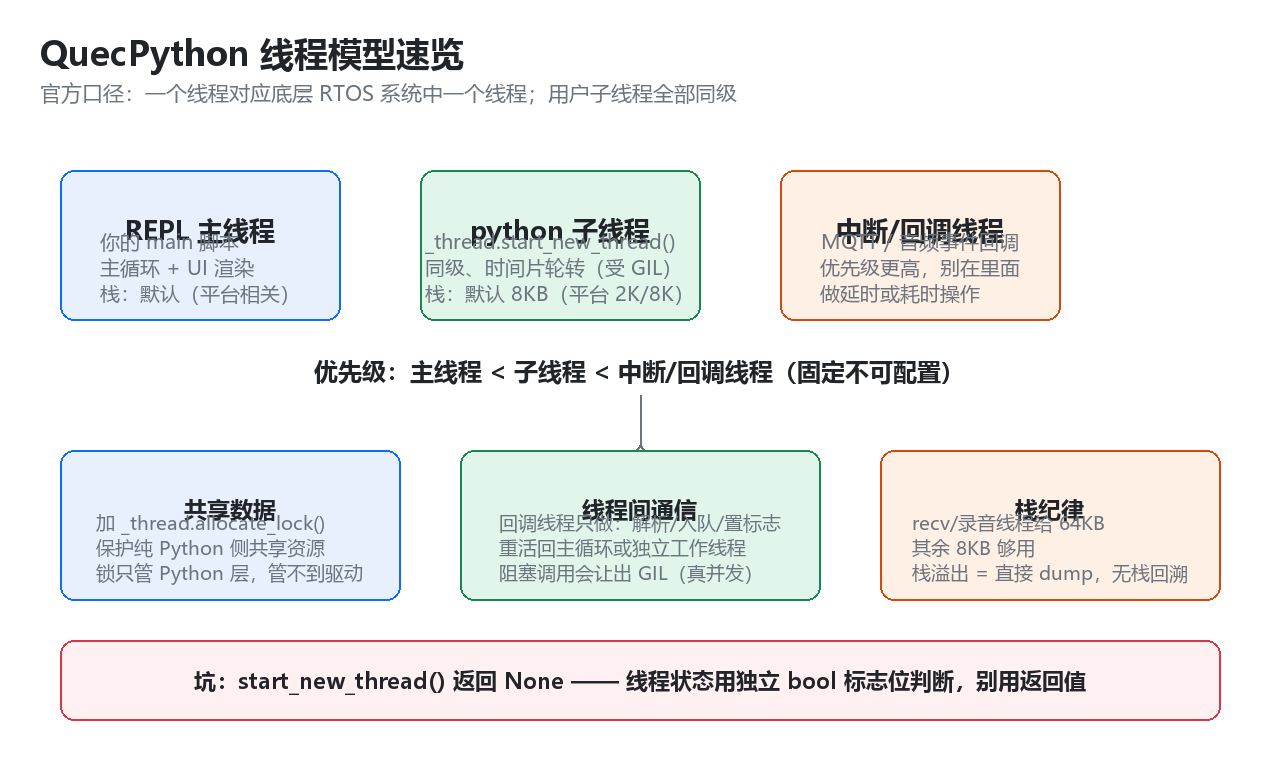
在 EC600M 上做了几个多线程项目(播放器、相机、键鼠),把 QuecPython 多线程机制里“文档不长篇展开、但实测必须知道”的几点整理成一篇笔记。范围限定在 _thread 模块的使用层面,不展开内核实现。
线程是什么:官方口径
官方文档对 QuecPython 线程的表述是:一个线程对应底层 RTOS 系统中一个线程。也就是说 _thread.start_new_thread() 创建的不是 Python 层的模拟并发,而是实打实的 RTOS 任务(创建时会生成任务控制块)。这带来两个直接推论:
- 线程有真实的调度行为,阻塞调用(如
socket.send()、HTTP 请求)会让出 CPU,其他线程可以真正运行; - 线程栈是真实的栈,溢出就是硬错误。
具体底层 RTOS 内核是哪一个,官方没有公开说明,做应用也不需要关心——按“这是 RTOS 任务”来理解行为就够了。
优先级:固定且不可配置
实测结论:REPL 主线程 < Python 子线程 < 中断/回调线程,这个优先级顺序是固定的,用户没有任何 API 可以调整;所有用户子线程彼此同级。
同级线程怎么并发?靠 GIL:同一时刻只有一个线程在执行 Python 字节码,解释器执行一定数量指令后自动释放 GIL 切换线程。由此有一个非常重要的实践结论:
- 阻塞型调用(网络、串口)会让出 GIL——把网络丢到子线程是真并发,主循环不会因此变卡;
- 纯 CPU 密集的循环不会让出——子线程里做全表扫描、逐字节解析这类活,会把主循环(UI、按键)一起饿死。CPU 密集的活要么切块(处理一小段主动 sleep 让出),要么换思路。
线程栈:默认很小,按需分配
默认栈大小是 8KB(不同平台 2K/8K)。这个量级跑个循环没问题,但在子线程里做 HTTP 上传、base64 编码、JSON 组包就很容易爆——这些操作的单次局部变量开销就不小。
我们的分配惯例:网络收发、录音这类深调用链的线程给 64KB,其余轻量线程 8KB。另外记住:RTOS 栈溢出的表现是板卡直接 dump、无 Python 栈回溯,排查成本极高;栈参数在创建线程时传入,先评估调用链深度再定大小。
三个必须知道的工程细节
① start_new_thread() 返回 None。 不能像 CPython 那样拿返回值判断线程是否启动成功。用独立的 bool 标志位:线程函数第一行置 True,主流程置位前先等待/轮询。
② 中断/回调线程里不做耗时操作。 MQTT 消息回调、音频事件回调运行在更高优先级的上下文里,在里面发 HTTP、做延时,轻则阻塞事件流,重则与心跳线程重入同一 socket 导致线程静默死亡(这个问题我在相机项目里完整踩过,另文详述)。正确姿势:回调线程只做解析、入队、置标志三件事,重活全部交回主循环或独立工作线程。
③ 线程没有守护模式,停线程要自己收尾。 stop_thread 是比较暴力的关闭方式,锁和内存的清理要自己负责。实践中更稳的做法是“协作式退出”:全局 running 标志 + 线程循环里检查,退出前把队列排空。
一张速查表
| 事项 | 结论 |
|---|---|
| 线程本质 | 对应底层 RTOS 任务(官方口径) |
| 优先级 | 主 < 子 < 回调;固定不可配;用户子线程同级 |
| 并发行为 | 阻塞调用让出 GIL(真并发);纯 CPU 循环会饿死别人 |
| 默认栈 | 8KB;深调用链线程给 64KB;溢出直接 dump |
| 启动判断 | start_new_thread 返回 None,用标志位 |
| 回调纪律 | 只解析/入队/置标志,重活回主循环 |
| 退出方式 | 协作式 running 标志优于 stop_thread |
多线程在 QuecPython 上是“能用但要懂脾气”的状态:把上面这几条记牢,大部分诡异问题(UI 卡死、莫名 dump、线程无声消失)都能提前规避。