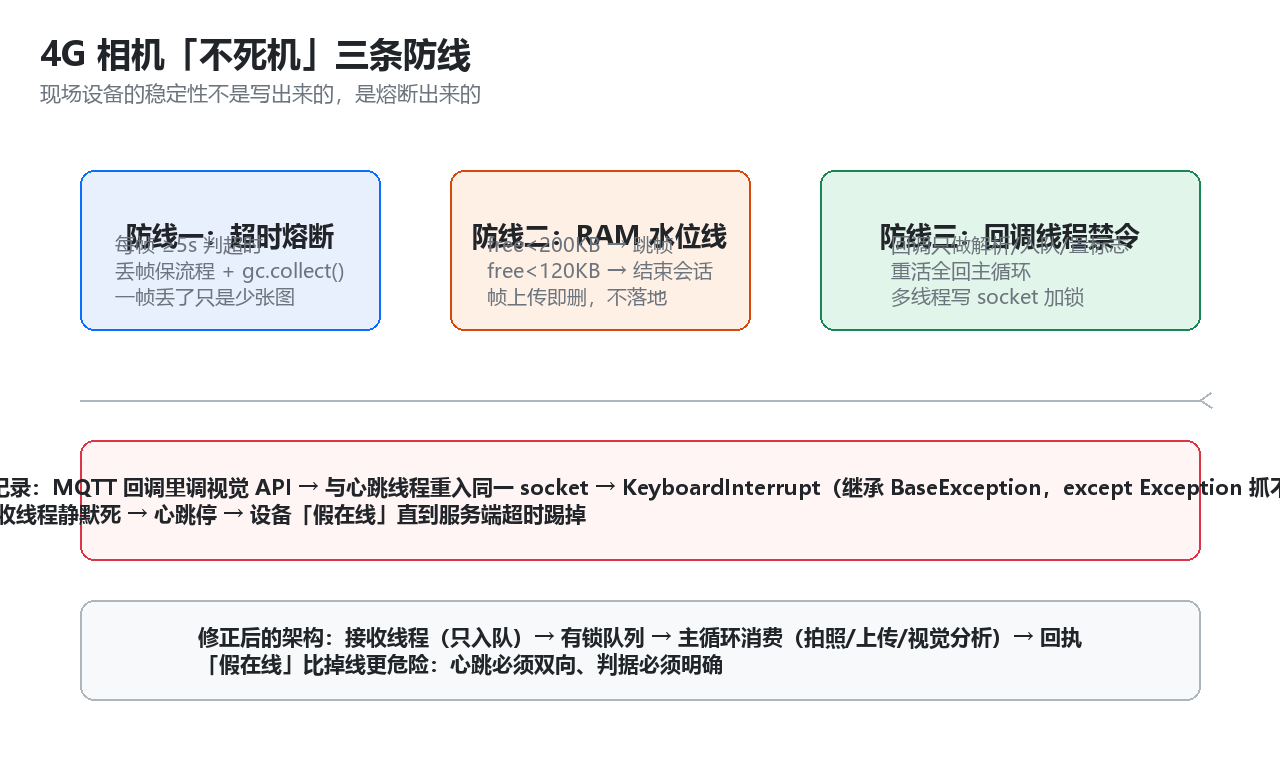
语音控制 AI 相机(EC600M-CNLE + GC032A + 小智语音 + MQTT + 视觉 API + 网页监控)开发到后期,功能早就调通了,真正的工程量在另一头:这是个要放在现场没人看着的设备。半夜死机一次,第二天过去按复位键,体验全毁。这篇讲我为“不死机”做的三条防线,以及一条用掉线换来的教训。
防线一:超时熔断——每帧 5 秒
4G 网络差的时候,一帧照片从拍照到上传可以卡 10 秒以上。如果死等,连锁反应是:主循环卡住 → UI 冻住 → 待传队列爆满 → 后面全堵。规则极简:
if utime.ticks_diff(now, frame_start) > 5000:   # ≥5s/帧,判超时
    skip_frame()          # 丢帧,保流程
    gc.collect()          # 顺手回收
现场设备的哲学:一帧照片丢了只是少张图,流程死了就是整台设备下线。宁可丢帧,不可卡死。
防线二:RAM 水位线
EC600M 可用 RAM 只有几百 KB,而“拍照 → base64 → HTTP 上传”是全流程内存峰值最高的环节:base64 本身就把数据放大 1.33 倍,加上表单包装和 URL-safe 替换的中间副本,单帧足迹几十 KB 起步。策略是两条水位线:
free RAM < 200KB  → 主动跳帧(不拍照不传图,只保命)
free RAM < 120KB  → 结束当前会话(视觉/语音链路全断,回待机界面)
帧上传成功       → 立即删本地文件(定时连拍不落地,Flash 不塞满)
关键路径上 del 大对象 + gc.collect() 显式削峰。有个反直觉的点:GC 不能乱调——它和 DMA 会打架,摄像头帧缓冲正被 DMA 读的时候 collect,可能直接 dump。要收集,选在“刚产生完大对象且硬件不持有”的间隙(拍照后、上传后),别在播放/取景途中收集。
防线三:回调线程禁令——用一次“静默掉线”换来的
这是全文最想写的一段。当时给相机加功能:MQTT 收到云端指令 → 在回调里直接调视觉 API 分析 → 结果回传。代码看着天衣无缝,本地测试全过。上真机跑了一段时间,设备开始隔三差五掉线,而且没有任何报错日志——串口安安静静,设备就“假在线”直到服务端超时踢掉。
排查过程值得记录:先查网络(4G 信号正常)→ 再查 MQTT keepalive(配置没问题)→ 最后把回调里那条视觉调用挪出去,掉线消失。根因:
在 MQTT 回调里调视觉 API,与心跳线程重入了同一个 socket。 底层抛了个
KeyboardInterrupt——注意,它继承自BaseException,except Exception根本抓不住——接收线程静默死掉,心跳跟着停,设备进入“假在线”状态。
移远官方 FAQ 说得很直白:中断/回调里不做延时、不做耗时操作。QuecPython 的线程对应底层 RTOS 任务,回调线程的角色是“信号来了喊一嗓子”,不是干活的。修正后的架构:
# 回调线程:只做三件事——解析、入队、置标志。绝不碰外设,绝不在这里发 socket。
def _on_mqtt_cmd(topic, msg):
    with _cmd_lock:
        _cmd_queue.append(msg)
    _cmd_flag = True

# 主循环:空闲时消费队列,视觉分析、上传这些重活全在这干
def main_loop():
    while True:
        if _cmd_flag:
            drain_cmd_queue()
        ...
        utime.sleep_ms(50)
多线程写同一个 socket 的地方,加 _thread.allocate_lock() 串行化——纯 CPU 操作,锁有效;驱动层加不了锁(预编译黑盒),就用“单一所有者 + 队列”把并发从架构上消掉。这次之后我给项目定了一条铁律:回调里出现任何网络/外设调用,code review 直接打回。
语音是怎么变成一张照片的
顺带记一下控制链路,这是整个项目最有意思的部分:
按住 PTT 说话 → Opus 60kbps 录音上传 → 小智平台 STT + LLM
    → LLM 看到 tools 列表里的 camera.take_photo
    → 决定调用 → MCP call 消息经 WebSocket 下发
    → 设备端触发拍照 → 入队上传
    → 回执回云端 → TTS “已为你拍好”
设备端不做完整 MCP Server,只做执行器,JSON-RPC 的复杂度留给云端桥。踩过一个 LLM 侧的坑:tools 定义里 inputSchema 写成空 dict {},LLM 的 schema 校验器会把顶层推断成 null,报 Invalid schema for function ... schema must be 'type: object', got 'type: null'——必须显式写 "inputSchema": {"type": "object", "properties": {}}。这种坑文档不会写,只有 LLM 的报错信息会告诉你。
心得
- 现场设备的稳定性不是写出来的,是“熔断”出来的:超时熔断保流程、水位线保内存、回调禁令保线程。三条都在,才敢让设备没人看着跑。
- “假在线”比掉线更危险。掉线你至少知道;假在线是设备以为自己在服务,云端以为设备还在线,用户以为指令发出去了。心跳要双向、判据要明确。
- 异常要能抓住 BaseException。
except Exception抓不到 KeyboardInterrupt 是常识,但在嵌入式多线程场景里,它的实际杀伤是“线程静默死亡且无日志”——比崩溃更难排查。关键线程加保活监控。